上传照片和音频,生成 AI 数字人口播视频
用人像照片和现成音频生成说话视频,让人物口型、表情和头部动作跟随声音。
上传照片和音频,生成 AI 数字人口播视频
用人像照片和现成音频生成说话视频,让人物口型、表情和头部动作跟随声音。
AI 数字人生成器,让照片开口说话
使用人像照片和音频生成数字人口播视频,也可以选用预设形象。VidGen AI Avatar 1.0 Standard 支持 480p、720p 和最长 10 分钟的音频;Kling AI Avatar 2.0 支持 720p、1080p 和最长 5 分钟的音频。
照片说话效果示例
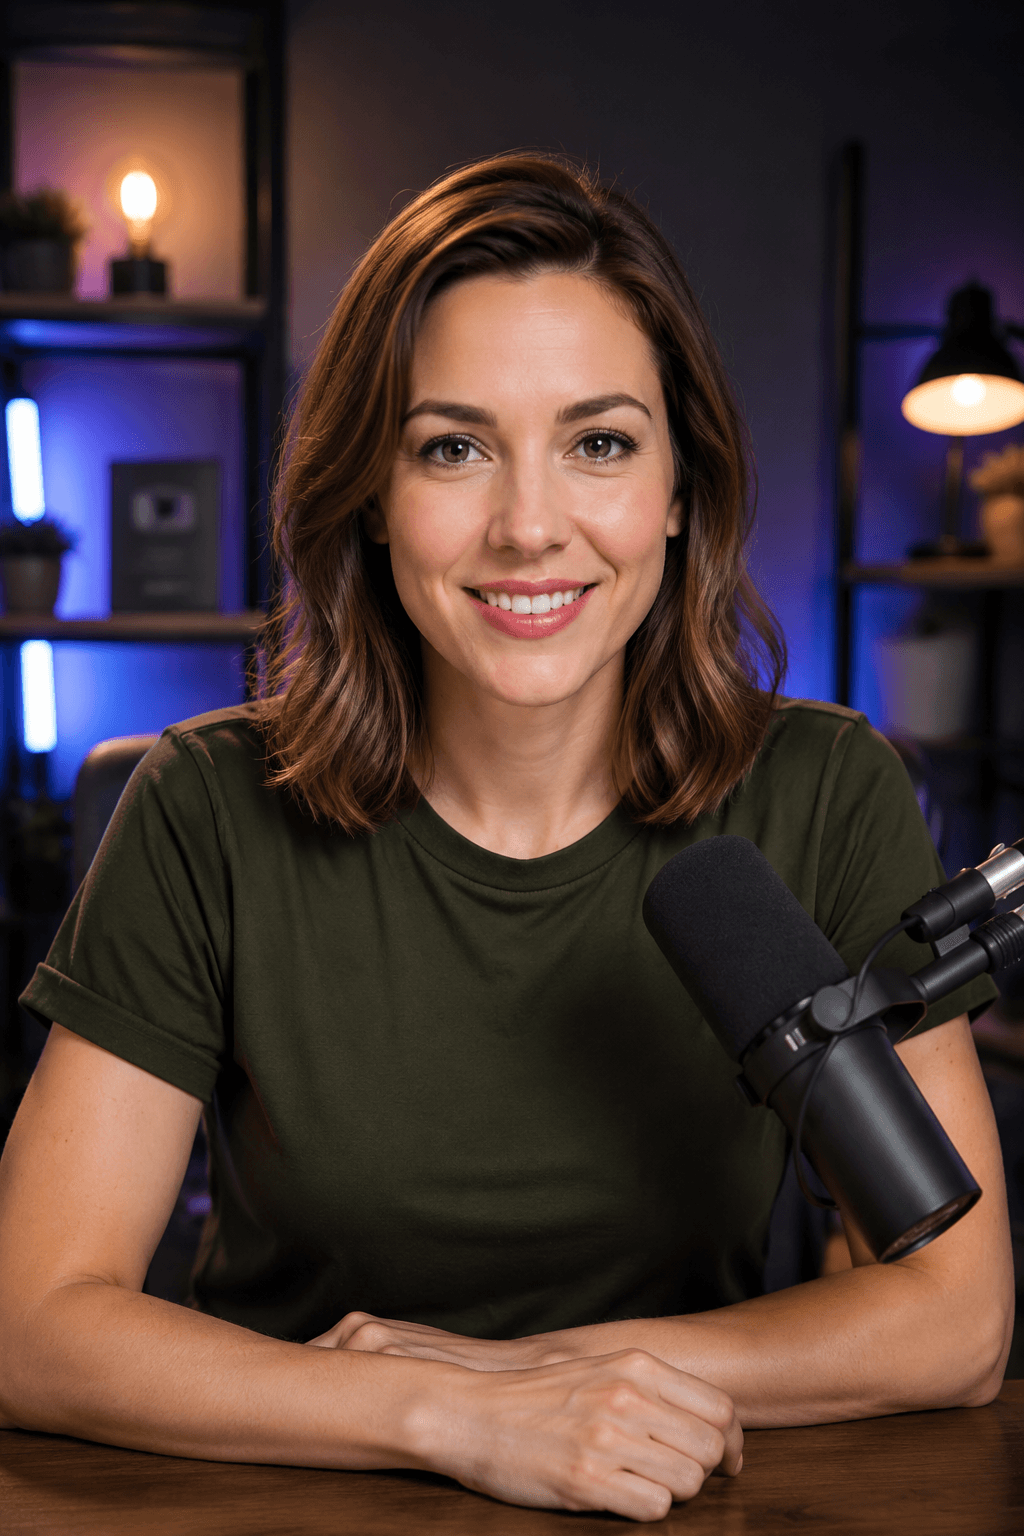
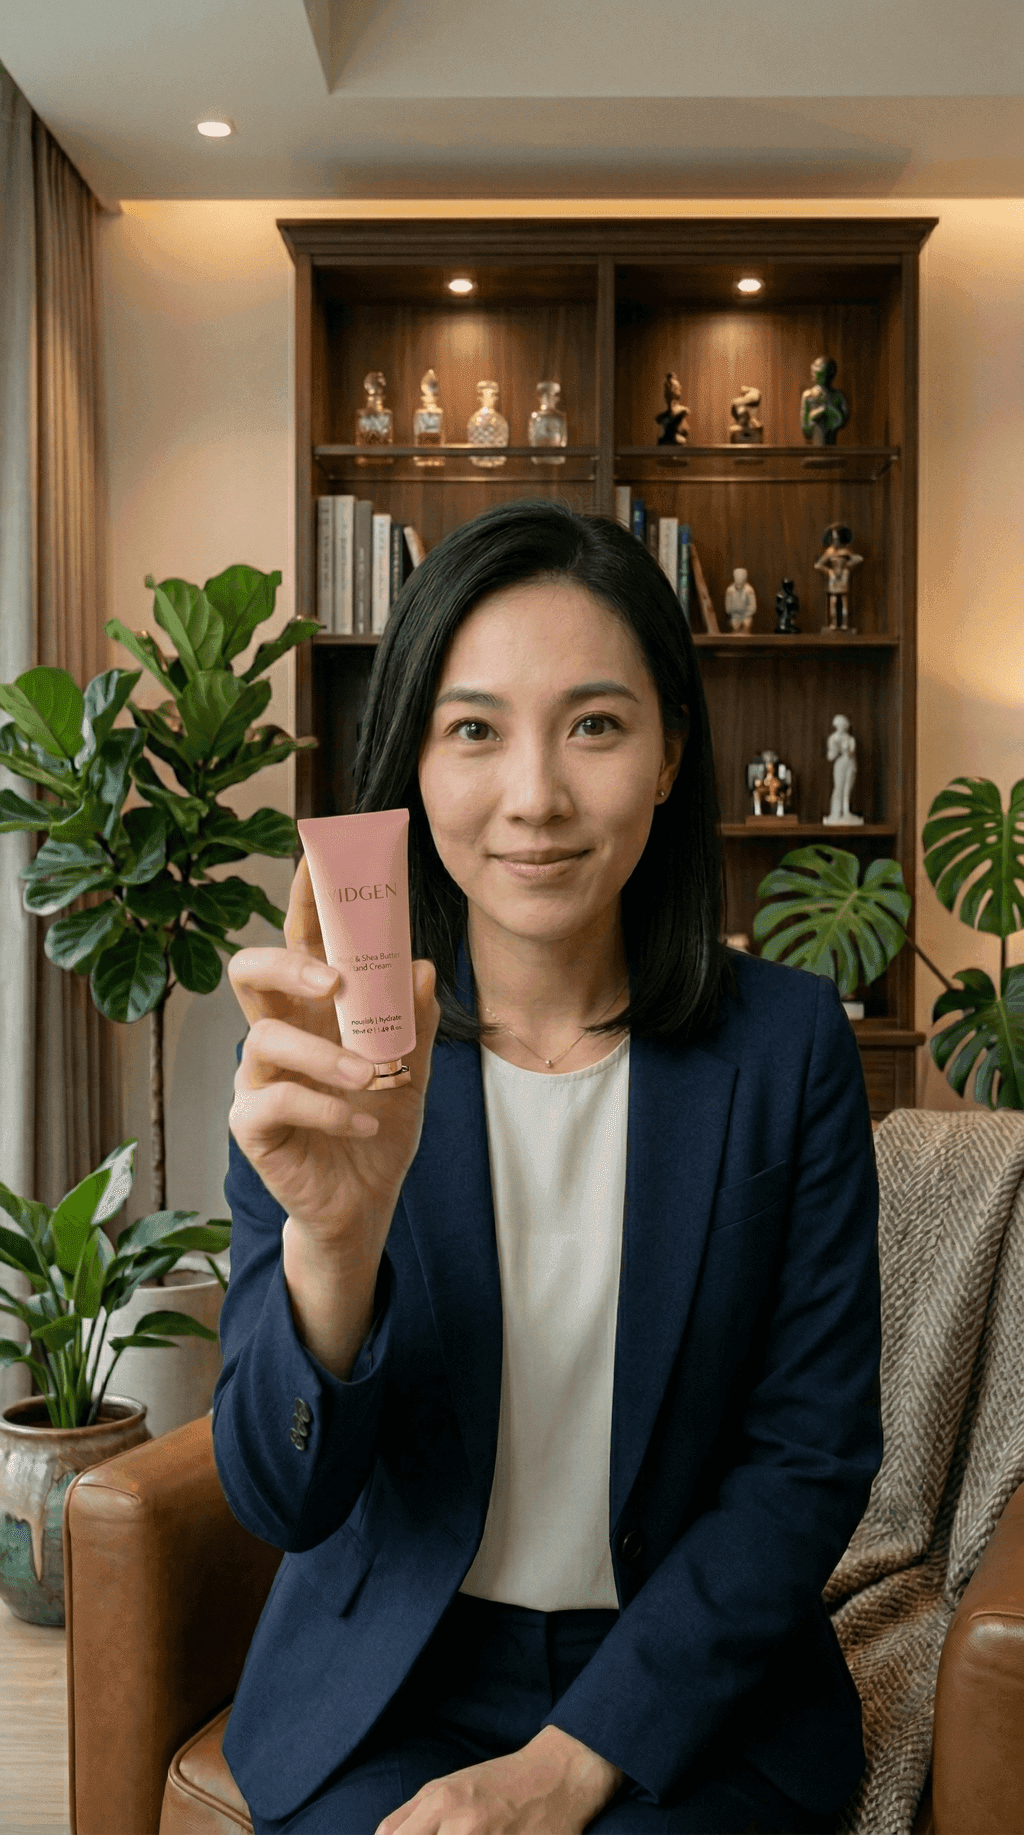
下面的示例使用一张人像照片和一段音频生成口播视频。播放音频并对照视频,查看口型是否与声音同步,以及人物的表情和头部动作。制作自己的内容时,可以先用短音频查看效果,再生成较长的视频。
人像与音频
数字人口播视频
如何用自己的音频让照片说话
准备清晰人像和至少 5 秒的录音,选择模型后预览生成效果。
第一步:上传人像与音频
选择面部清晰、正对镜头的单人人像,或使用预设形象。先上传一张不超过 10 MB 的图片,再添加音频文件。两款模型都支持 WAV 和 MP3,音频大小和时长限制请按所选模型确认。
第二步:选择模型并描述人物动作
VidGen AI Avatar 1.0 Standard 可选 480p 或 720p,Kling AI Avatar 2.0 可选 720p 或 1080p。保留默认的自然说话和轻微动作描述,或改写希望出现的表情与动作。人物说什么仍由录音决定。
第三步:生成、预览并下载
查看所需积分并开始生成。播放视频时打开声音,检查口型与声音是否同步,以及人物的面部动作。如需调整,可以换用更清晰的录音、不同人像或新的动作描述,再下载需要使用的成片。
AI 数字人口播常见问题
这个 AI 数字人生成器能制作什么?
它会把静态人像照片和音频文件组合成会说话的数字人视频。照片提供人物外观,录音提供台词与声音,适合制作自我介绍、讲解等预录口播内容,无需重新拍摄人物说话的镜头。
只输入台词就能让照片说话吗?
当前页面需要上传音频。请先录好台词,或在其他语音工具中生成音频,再与人像一起上传。动作提示词用于描述表情和动作,不会把文字转换成语音,也不会从照片生成声音。
两款数字人模型和清晰度应该怎么选?
VidGen AI Avatar 1.0 Standard 支持 480p、720p,以及最长 10 分钟的录音;Kling AI Avatar 2.0 支持 720p、1080p,以及最长 5 分钟的录音。需要 1080p 时选择 Kling,录音超过 5 分钟时选择 Standard。可以先用短音频比较同一张人像的生成效果。
支持哪些人像和音频文件?
两款模型均支持最大 10 MB 的 JPG、PNG、BMP、WebP 人像,图片宽高各为 400–7000 像素。Standard 支持 5–600 秒、最大 50 MB 的 WAV 或 MP3 音频;Kling 支持 5–300 秒、最大 100 MB 的 MP3、WAV、AAC、M4A、OGG 音频。
可以保留默认动作提示词吗?
可以。你可以保留默认的自然说话、面部表情和头部动作描述,也可以替换成自己的要求,例如放松的表情和轻微的头部动作。请在输入框中保留一段动作描述,人物台词与声音仍来自上传音频。
可以上传其他语言的音频吗?会自动翻译吗?
数字人会跟随上传的音频及其原有语言生成视频,本页不会自动翻译语音。需要另一种语言时,请先准备对应语言的音频。口型效果会受发音、录音质量和模型影响,建议先预览短片,再制作较长的版本。
怎样让照片说话的效果更清晰自然?
选用面部清晰、光线充足的人像,并准备只有一位说话者的清晰录音。背景噪声、多人同时说话或面部遮挡都可能影响效果。预览时打开声音,检查口型与声音的同步情况,以及眼部和头部动作,再决定是否使用成片。
可以用免费积分体验 AI 数字人吗?
新账号会获得体验积分。是否足够完成一次生成,取决于所选模型、清晰度和音频长度,请以生成前显示的所需积分为准。较长的录音或更高清晰度可能需要超出体验余额的积分。
AI 数字人和 AI 口型同步有什么区别?
AI 数字人从静态人像照片生成说话视频;AI 口型同步使用已有视频和另一段音频,对人物嘴型进行同步。有照片时选择 AI 数字人,已经有视频时选择 AI 口型同步。
数字人口播视频可以用在哪些场景?
可以用于自我介绍、课程讲解、产品展示或社交媒体短内容。先录好要表达的信息,再选择适合场景的人像。需要制作多个版本时,可以沿用同一张照片、更换音频,并逐一检查生成结果。